
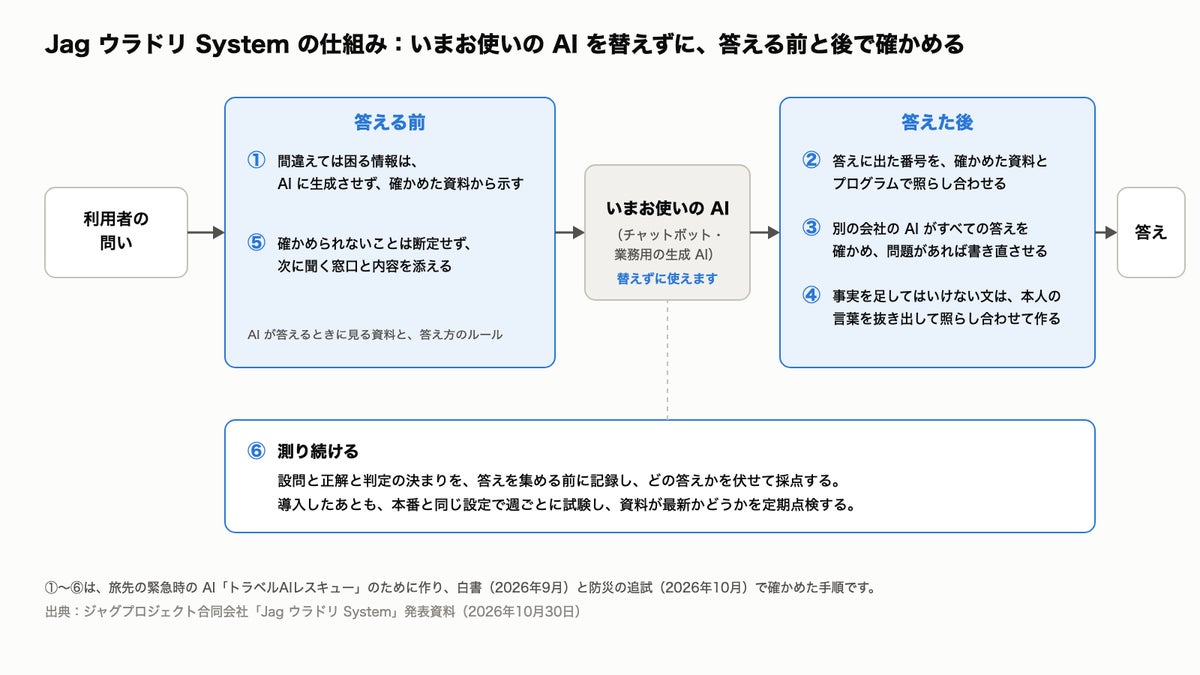
ジャグプロジェクト合同会社(本社:東京都江東区、代表:Jag Yamamoto)は2026年10月30日、生成AIの誤回答を抑える仕組み「Jag ウラドリ System」を、旅行以外の分野の事業者・団体に提供する取り組みを始めた。チャットボットや業務用の生成AIなど、現在使っているAIは替えない。AIが回答するときに参照する資料と答え方のルールを確かめ、導入後も定期的に回答を測定する。
あわせて、防災分野で行った追試の結果も公開した。防災の相談30問のうち、公的な情報と食い違ったAIの回答は、仕組みを当てる前の16問から0問になった(2026年10月2日測定)。設問と採点の基準は回答を作る前に記録しており、どの回答がどの形によるものかを伏せて採点している。
AI導入後の「確かめ方」は、使う側の宿題に
帝国データバンクの「生成AIに関する企業の動向調査」(2026年3月)によると、生成AIを業務で使う企業の懸念の1位は「情報の正確性」で、50.4%だった。誰でも使えるチャットAIの回答はほとんどが正しいため、そこに混じった誤りには気づきにくい。誤りは、窓口・電話番号・手続き・期限のように地域や組織ごとに異なる事実に集まる。デジタル庁の「生成AIの調達・利活用に係るガイドライン」(2026年6月改定)は、調達のチェック項目に「偽誤情報の出力・誘導の防止措置」「データ品質」「検証可能性」を置き、運用開始後も安全性や品質を定期的に検証するよう求める。金融庁もAIディスカッションペーパー第1.1版(2026年3月)で、顧客対応にAIを使う際の注意喚起と、運用状況の記録・モニタリングを論点に挙げている。同社は、AIを入れたあとに「正しく動いているかを誰がどう確かめるか」が、使う側の宿題になったとしている。
報道の「裏取り」をAIの回答の前後に置く6つの手順
報道では、伝える前に別の資料で事実を確かめることを「裏取り」と呼ぶ。Jag ウラドリ Systemは、この考え方をAIが答える前と後に組み込む仕組みだ。同社が旅行の緊急時のAI「トラベルAIレスキュー」で作り、2026年10月7日公開の調査白書で確かめてきた、次の6つの手順で構成される。
- 生成させない:番号・住所・窓口など、地域や機関に固有の事実は、確かめた資料にあるものだけを答える
- 照らし合わせる:回答の中の番号と場所を、資料と機械で照合する
- 別のAIが確かめる:回答したAIとは別の会社のAIが回答を読み、見落としや言い過ぎを指摘する
- 抜き出して組み立てる:報告や書類の下書きは、相談の文から事実を抜き出して組み立てる
- 分からないときは次の一手を添える:資料に無いことは「確かめられない」と答え、どこに何を聞けばよいかを添える
- 測り続ける:同じ問いを定期的に答えさせ、基準と比べる
防災の追試と、これまでの検証結果
江東区・江戸川区の防災相談30問で比較
追試の目的は、旅行以外の分野でも仕組みが働くかを確かめることだ。対象は防災の相談30問で、避難所・避難場所、災害時の給水、区の防災の窓口と電話番号、罹災証明書の申請、帰宅困難者、ハザードマップを扱った。内訳は東京都江東区24問・江戸川区6問で、整った書き方と崩れた書き方が15問ずつ。正解は区・都・国の公式ページで確かめた事実とした。仕組みを当てる前の同じAIでは、公的な情報と食い違った回答が30問中16問あったが、Jag ウラドリ Systemを当てた形では0問だった。江東区の24問では、回答に含まれた要点の割合が51.4%から93.8%に上がった。比較対象にした誰でも使えるチャットAI2つの食い違いは、7問と0問だった。0問だったAIは30問中20問で「確かめられない」と答えており、江東区の要点の割合は35.4%だった。
なお、同社の形は江東区の公的な情報で確かめた資料を参照して答えるため、比較の条件は同じではない。その資料が無い江戸川区の6問では、確かめられない事実を答えなかったため、要点の割合は9.7%にとどまった。そのかわり6問すべてで、確認先の窓口と聞く内容を添えた。
測定方法は次のとおり。比較したチャットAI2つの名前は伏せており、白書の「一般のチャットAI」と同じ種類だという。各社のAPIから、指示と検索なしで呼び出した。判定は記憶を持たないAIの採点担当2人が、どの回答かを伏せて行い、2人の判定の一致は99.2%だった。食い違いと判定された回答は、別の担当が公的なページで確かめた。設問・正解・判定の決まりは、回答を集める前にSHA-256で記録した。2026年10月13日に同じ設問でもう一度測ったところ、そのままの同じAIの食い違いは15問、Jag ウラドリ Systemは0問だった。別の採点担当2人が10月2日の回答を採点し直しても、食い違いの数は同じで、要点の割合の差は4ポイント以内だった。
旅行分野などでの検証
- 国ごとに違う連絡先と手続きの74問で、公的な情報と食い違った回答は、同社の旅行向けAI「トラベルAIレスキュー」が0件、誰でも使えるチャットAI3つが14~18件だった(2026年9月22日)。同社の形は確かめた資料を参照して答えるため、比較の条件は同じではない
- 旅行の相談で、詐欺の手口と本物の相談を見分けられた組の数は、40組中28組から35組になった。別の会社のAIが回答を確かめる仕組みを入れる前と後の比較(2026年9月26日~27日)
- 会社への報告の下書きに含まれていた事実でない記載は、5件から0件になった。文章を生成させる形から、相談の文から抜き出して組み立てる形に変えた結果(2026年9月)
- 同じ裏取りの手順を、公開されている防災の配布物21件と避難所の一覧表2件の計396項目に当てたところ、今の公式の情報と合っていたのは92%だった(2026年10月7日、同社調べ)。残りは移転・閉園・改訂・申請期限など、時間とともに変わるものだった
同社は2026年10月2日から13日にかけて、防災・医療・会話・資料の読み取り・出典・FAQなど6つの追試と9つの実験を同じ手順で行い、効果が確かめられなかったものも記録している(公開したのは防災の追試の結果)。本番で回答するAIの設定は、2026年10月2日時点のものだ。及ばなかった点も示している。同社の形は確かめられない事実を答えないことを優先するため、白書では一般的な質問で誰でも使えるチャットAIを12.5ポイント下回る結果が出た。同じ理由で、参照データの無い地域では要点の割合が低くなる(江戸川区6問で9.7%)。比較したAIの名前、研究の中身の一部、事業者向けの価格と条件は公開しない。
提供の形と、入口となる「誤回答の診断」
- 仕組みの提供:導入企業のAIの回答を、Jag ウラドリ Systemが確かめてから出す形
- AIが参照する資料の整備と、最新かどうかの定期点検:公的な情報や企業の規程をもとに、用件・窓口・電話番号・受付時間・言い換え・出典・確認日を項目ごとに整理した一覧表を作る。週ごとに公式の情報を確かめ、変わった項目を知らせる
- 誤回答の診断:今使っているAIの回答を、測る前に基準を決めて記録し、どの回答かを伏せて採点する方法で測り、報告書にまとめる。国の調達ガイドラインの項目(偽誤情報の防止・データ品質・検証可能性)に対応した検証の設計書も作る
- 分野ごとのアプリ
最初の窓口になるのは「誤回答の診断」だ。成果物は、設問と正解の根拠(URLつき)、公的な情報と食い違った回答の一覧、要点の網羅率、危ない回答の例、直し方の提案(AIが参照する資料に足す項目、答え方のルールの修正)。期間の目安は2週間で、測定中は今使っているAIに手を加えない。価格は相談に応じる。代表のJag Yamamoto氏は、旅先の緊急時に電話番号を一つも間違えずに案内するために作った手順を防災の相談で確かめたと説明する。同じAIでも、公的な情報を確かめた資料と答え方のルールを置くだけで、食い違いは16問から0問になったという。今使っているAIを替えずに裏取りを続ける仕組みを、旅行以外の分野にも届けるとしている。